Linux研发环境不仅能敲代码,还能做什么?
把 Linux 研发环境从"一台装了 Linux 的开发机"还原成一条可重复执行的工程链:编译构建与依赖管理、测试自动化、容器运行与部署、日志排障,以及内网、权限、信创带来的边界约束;并说明封闭环境下研发团队如何落地协作层,给出从环境定义到协作工具的起步顺序与边界提醒。
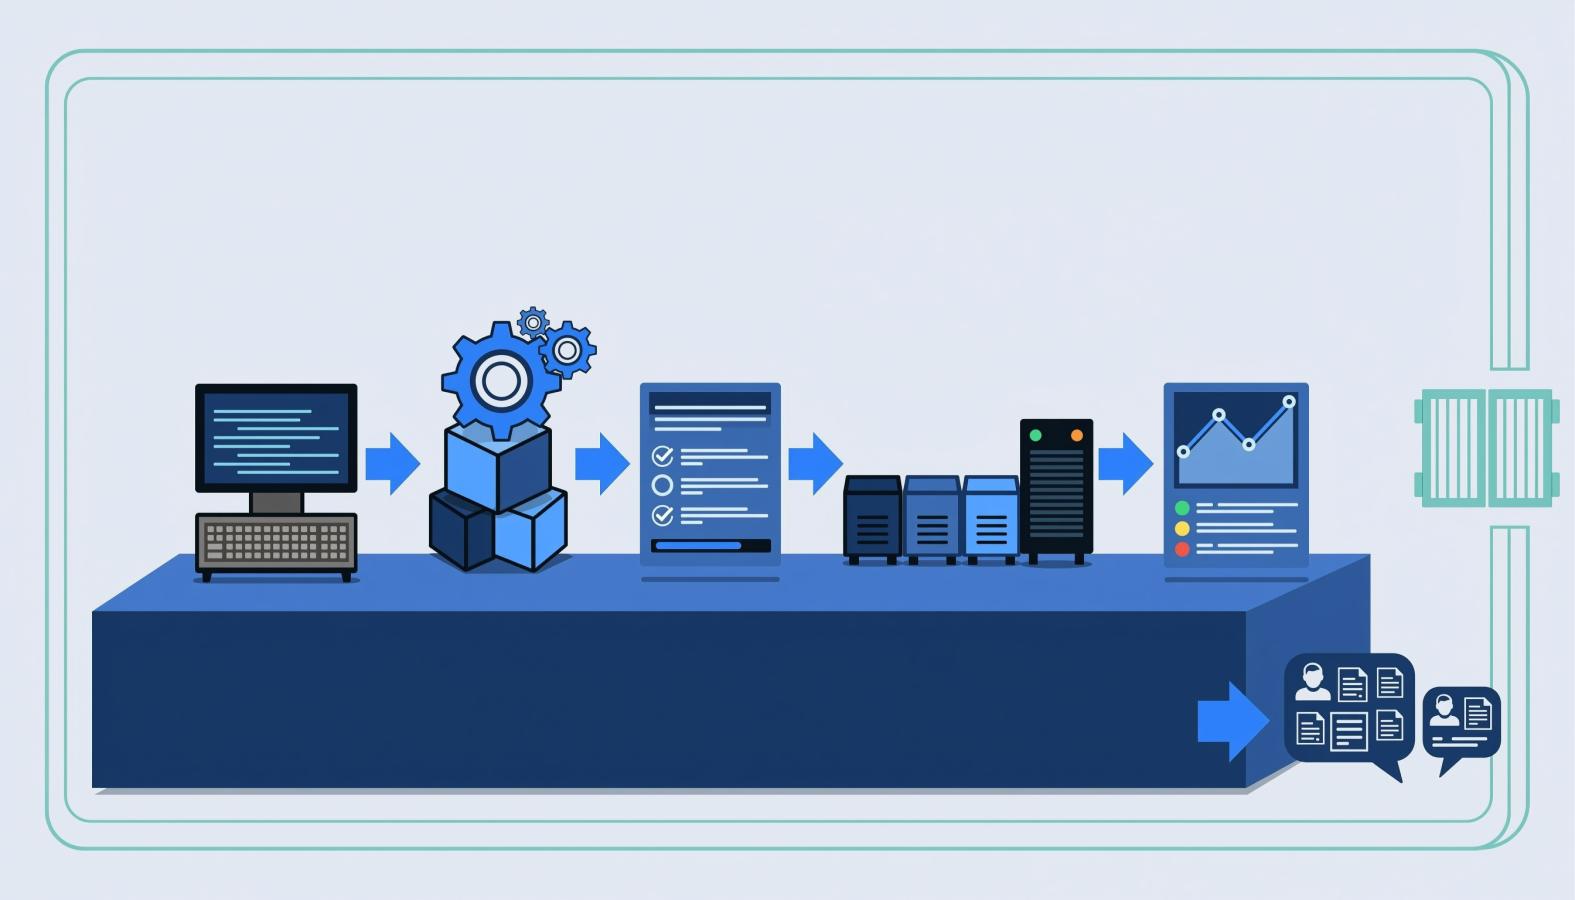
对不少研发同学来说,Linux 开发环境约等于一台装了 Linux 的开发机:打开终端,写代码,提交,关掉。但真正把流程跑顺的团队会发现,这套环境同时在做的事远不止编码, 它是把源码变成可交付产物的一条工程链,还顺带承担了排障、安全边界和团队沟通。
先给一份清单。一套成形度较高的 Linux 研发环境,通常同时承担七件事:
- 编译构建:把源码变成可运行的产物
- 依赖管理:拉取、缓存并隔离第三方库
- 测试与质量检查:自动跑用例和静态扫描
- 运行与部署:起服务、跑容器、做预发布验证
- 观测与排障:日志、指标、抓包、性能分析
- 安全与边界:账号、权限、网络隔离、审计
- 协作:代码讨论、问题反馈、任务流转
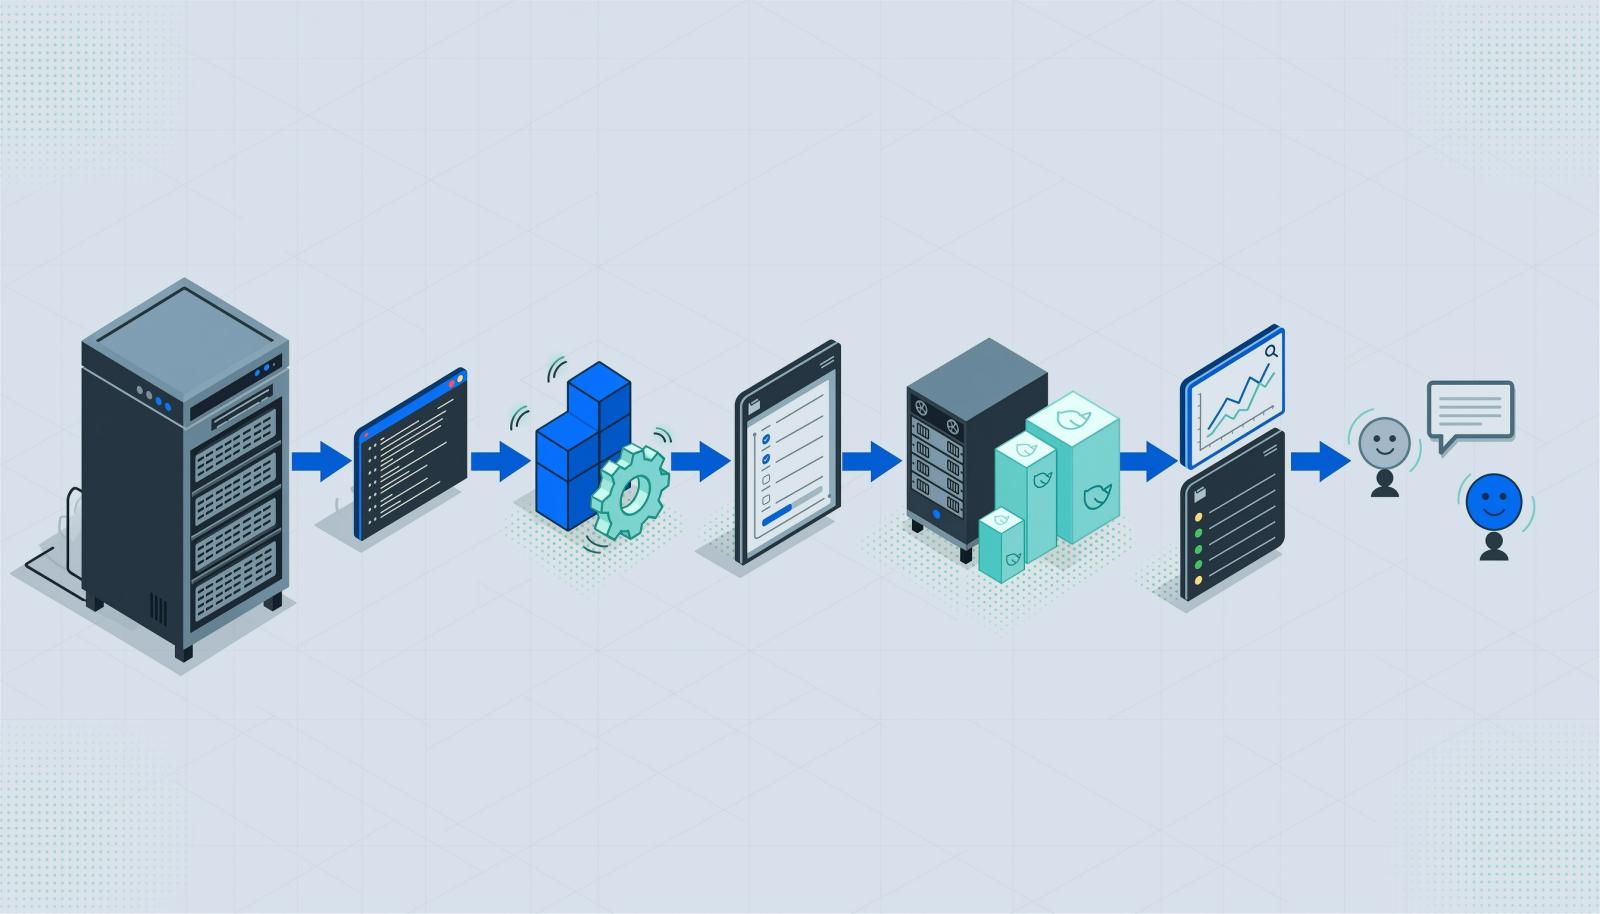
下面逐层说清每件事解决什么问题、边界在哪,最后回到很多人真正关心的那个问题:内网和信创环境里,团队沟通这一层怎么落地。
环境与机器的区别:能力是被固定下来的
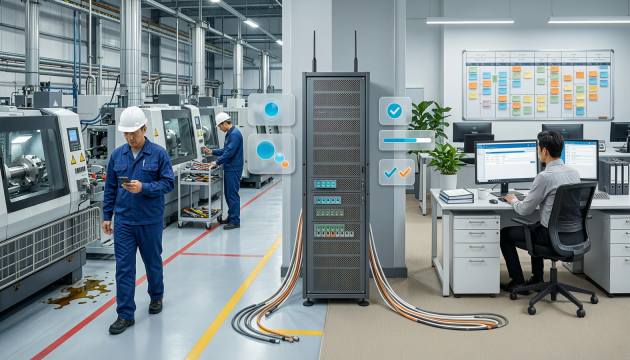
"有环境"和"有机器"的差别,在于 能力有没有被固定成可重复执行的形态。
一台机器上,编译器版本、依赖库、环境变量、目录结构、连接串,都存在某个人的操作记忆里;换个人接手,或者隔三个月再来一次,结果大概率不一样。一套环境会把这些写成可执行的东西:安装脚本、容器镜像、配置仓库、流水线配置。谁执行、什么时候执行,结果都一致。
这一点想清楚,后面就顺了。既然要求可重复,就必然要用到构建、测试、运行、部署这些环节;而这些环节能放在同一个地方,是因为它们共享同一条内核和同一套命令行工具。 Linux 研发环境的价值不在"能装什么",而在"同一套能力能被反复、稳定地调用"。
编译构建与依赖管理:环境本身就是构建平台
写代码只是把文件产生出来,把文件变成能交付的东西,是构建环节的事。
- 编译:gcc、clang 把源码翻译成目标文件,Make、CMake 这类构建系统描述"先做什么、再做什么"。
- 依赖:系统层的包管理器(Debian/Ubuntu 系的 apt,RHEL 系的 dnf、yum)解决运行库;语言层的包管理器解决项目内的第三方库。
- 依赖源:团队一大,直接从公网拉依赖会同时带来速度和安全问题, 把依赖收进内网私有源,是让构建结果可复现的前提。
- 交叉编译:构建平台与目标平台不一致时(例如在 x86 机器上产出 ARM 程序),需要在环境里准备交叉工具链。
这一层在 Linux 上阻力较小,因为工具链本身就是在 Linux 生态里长出来的。判断一套研发环境是否成形,第一个硬指标很简单: 构建能不能一条命令跑通。
测试与自动化:环境不一致,测试结果就不可比
测试的前提是环境一致。同一份代码在两套依赖不同的环境里跑,失败原因可能完全不同,结论也就没有参考价值。
环境固定之后,下面这些事可以稳定挂上去:
- 单元测试与集成测试:编译完成后直接执行,失败即中断
- 静态检查:代码规范、潜在缺陷、依赖许可证
- 定时任务:cron 或 systemd timer 周期性执行,不依赖谁记得
- 流水线执行机:构建和测试跑在同一类环境里,减少"本地能过、集成就挂"
边界也要说清:自动化解决的是"已知问题会不会反复出现"。 环境一致只能提高结果的可信度,用例没覆盖的场景,跑多少遍也不会自己暴露。
运行、容器与部署:研发环境常常就是预生产环境
写完、测完,下一步是让程序真的跑起来。这里要干的活比想象中多:起本地服务、连数据库、配反向代理、灌测试数据、验证升级和回滚路径。
容器是目前最常见的做法。 容器所需的进程隔离与资源限制由 Linux 内核直接提供:namespace 让进程看到独立的进程树、网络栈和挂载视图,cgroups 限制 CPU、内存和磁盘 I/O 的用量。容器运行时做的是把这些内核能力包装成好用的工具,隔离能力本身并不来自运行时。
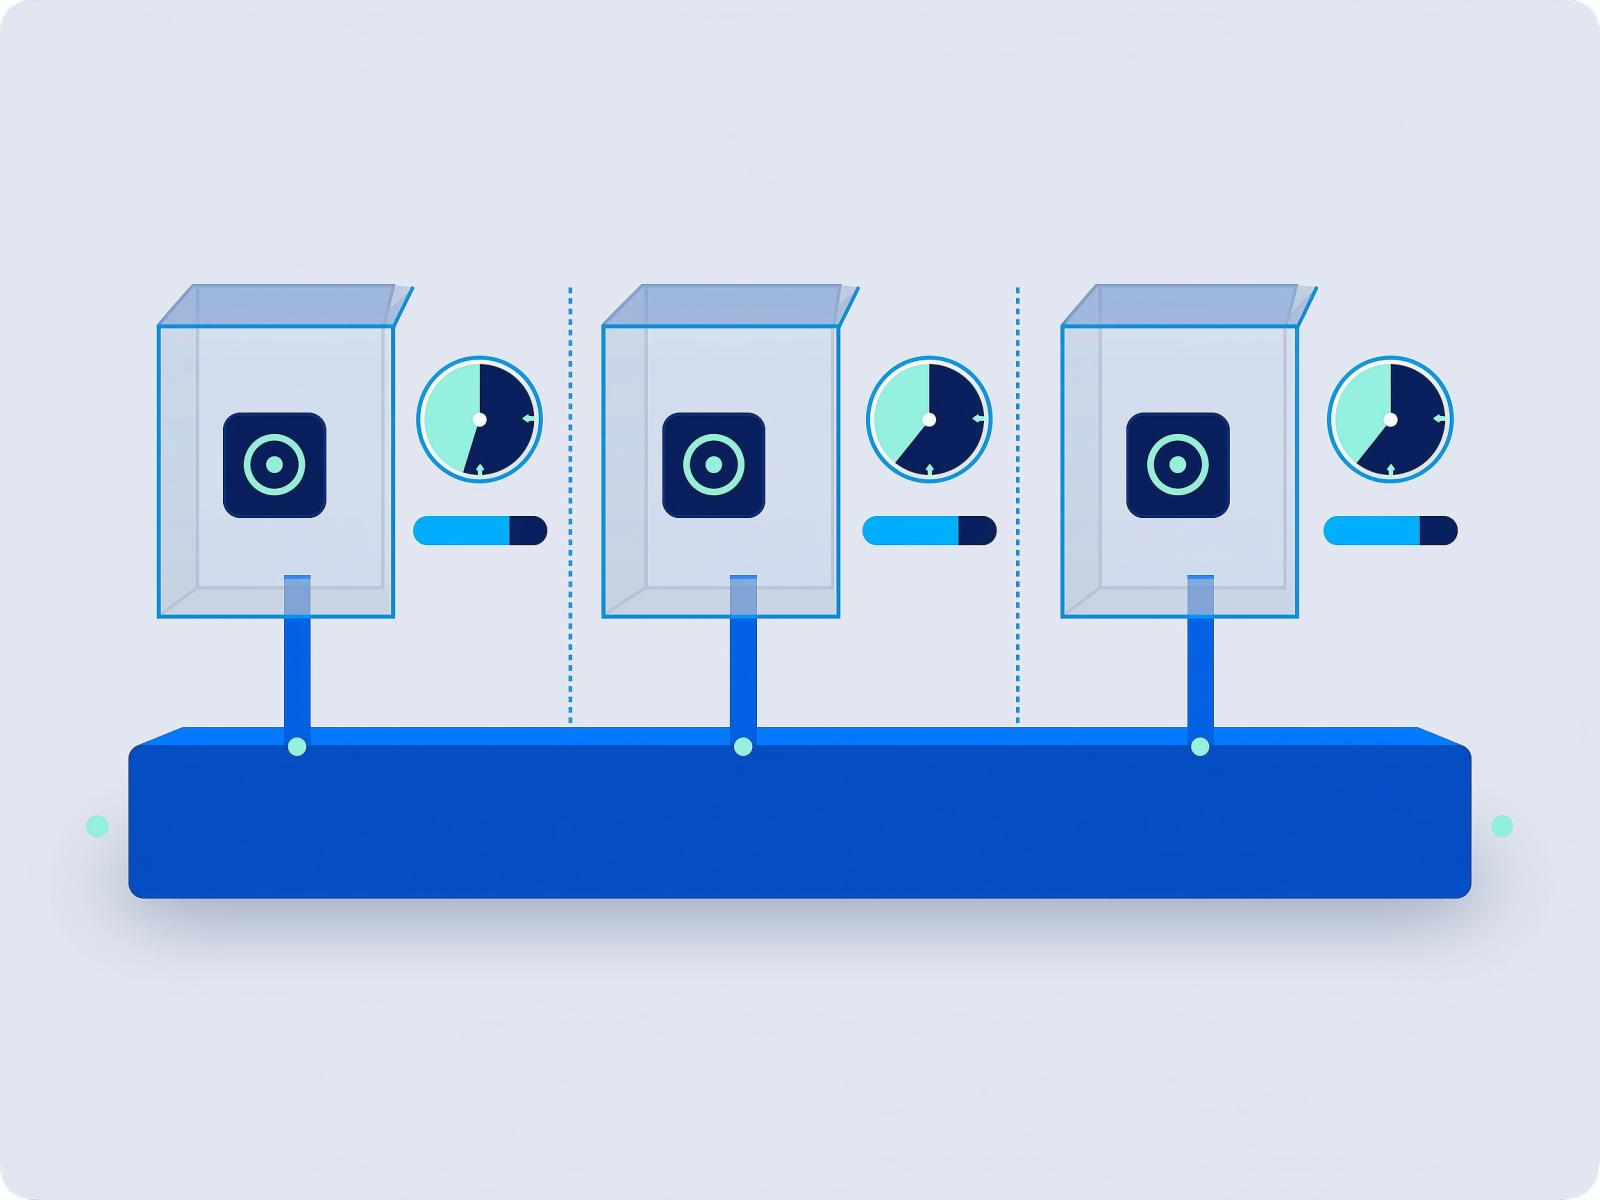
这也解释了容器在 Linux 研发环境里为什么普及:不需要额外的虚拟化层,启动快、占用低,镜像还能把"这套环境跑得起来"固化下来。但边界同样明确: 单机上的容器不等于生产高可用架构,没有多节点、没有编排、没有容量规划,它解决的是一致性,不解决可用性。
日志、数据与排障:真正花时间的战场
功能上线之后,研发的大部分时间花在回答"为什么不对"上,而这个答案通常只能从 Linux 环境里找:
- 日志:systemd 体系用 journalctl 看服务输出,应用日志靠 grep、awk、sed 一类文本工具筛
- 网络:tcpdump 抓包确认请求到底有没有到、在哪一跳断掉
- 进程与系统调用:strace 看程序卡在哪个调用上,top、vmstat、iostat 看资源被谁占住
- 性能:perf 一类采样工具定位热点函数
这些工具的共同点是 都在命令行里,输出能直接管道给下一条命令。排障效率的差距往往不在工具本身,而在于这台机器上有没有权限、有没有预装工具、日志有没有留存。所以成形度高的研发环境会把可观测性提前配好,而不是等出事之后再临时补。
内网、权限与数据边界:为什么很多研发环境是封闭的
前面这些工作都在机器内部完成,但它们不可能与外界完全无关。源码、依赖、日志、测试数据都要流转,而 这些内容的流转范围,直接决定了环境的边界。
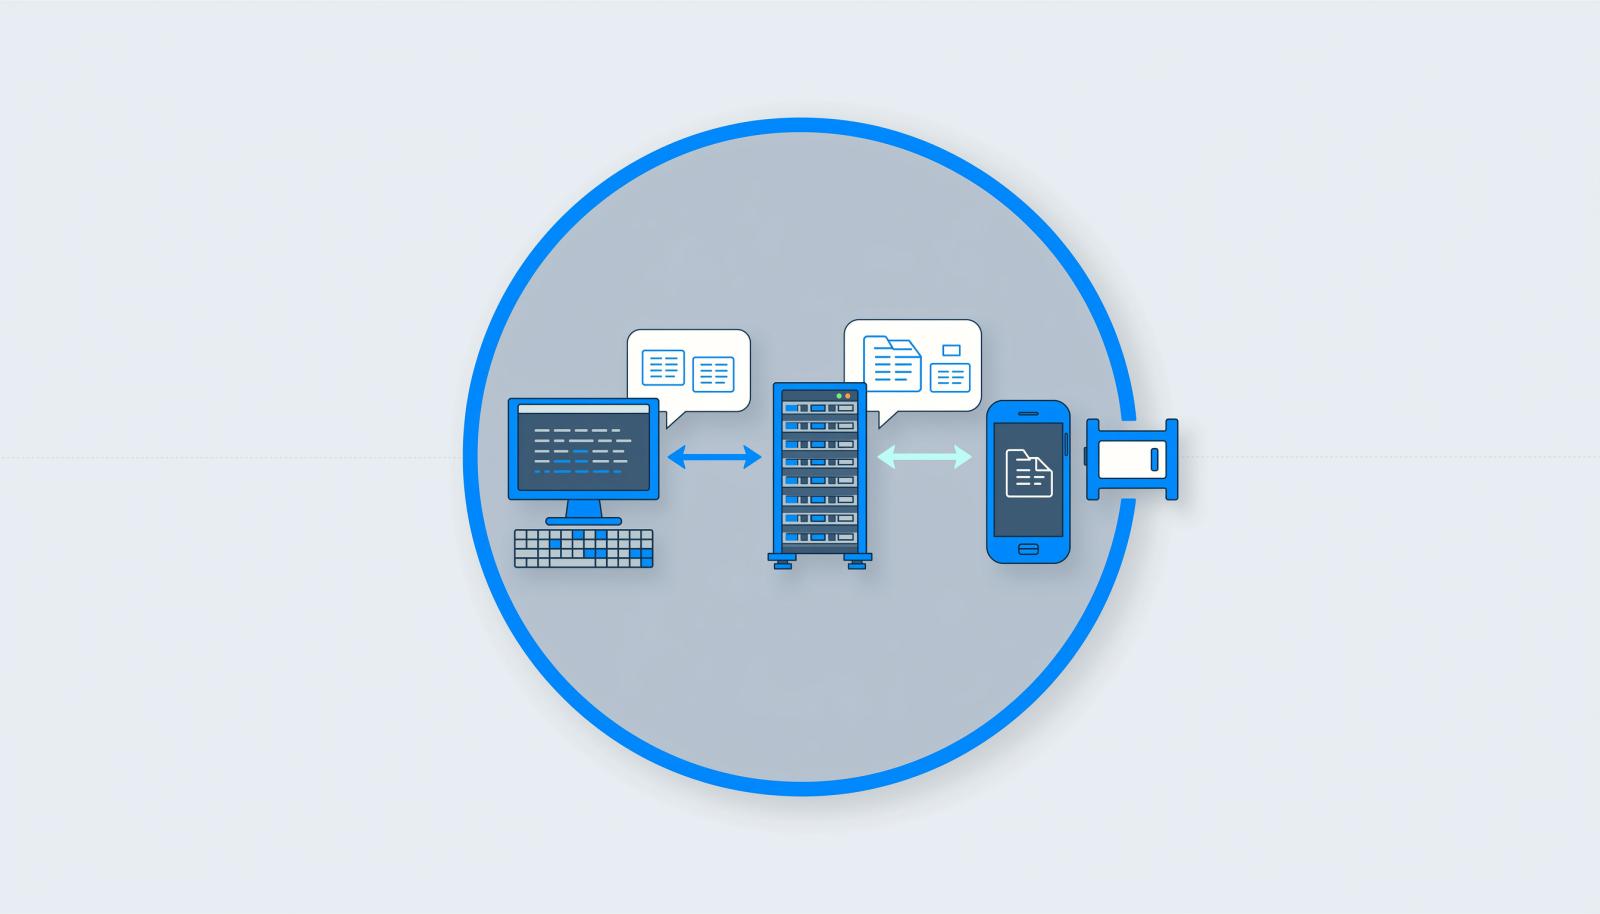
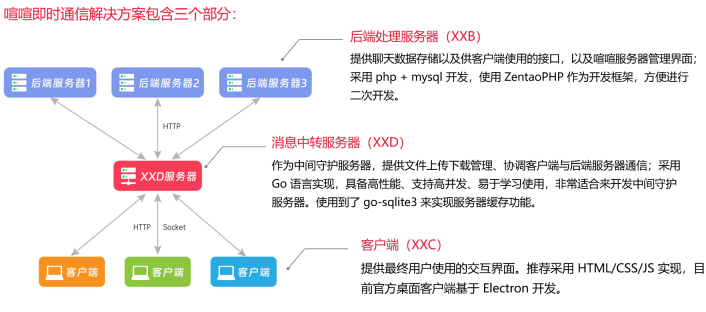
常见的两种网络形态:一种是服务器具备公网 IP,客户端通过公网访问;另一种是企业只允许内网访问,服务器不连接外网,所有客户端只能在内网里使用。后一种在研发场景并不少见,原因很直接:源码和测试数据一旦流出去,损失不可逆。
国内研发环境还有一层现实约束。国产操作系统(银河麒麟、统信 UOS、Deepin 等)本身属于 Linux 系, 信创要求下,研发环境经常需要在国产系统与国产处理器上完整跑通,这直接决定了哪些工具能用、怎么用。
因此合理的判断顺序是:先看数据能不能出企业,再看系统能不能装,最后才看功能够不够丰富。这个顺序反过来,收场会很麻烦。
协作层:内网研发环境里怎么"说话"
前面七件事,一个人也能做。但研发是协作活动,环境里迟早要解决团队沟通的问题,而在内网、信创环境下,这件事比想象的棘手。
公有云 SaaS 类工具在这里直接出局:数据存放在服务商一侧,多数纯内网环境访问不了,账号体系和组织结构也不在企业手里。剩下的路径基本只有一条: 把沟通工具也部署到企业自己的服务器上,也就是 私有化部署。
这类工具该看什么?三个判断点足够:
- 服务端能否装在企业自有服务器上,数据是否留在企业内部;
- 客户端是否覆盖研发实际在用的系统,Linux 桌面是否在支持范围内;
- 能不能和研发流程接上,让告警、构建结果、问题流转回到会话里。
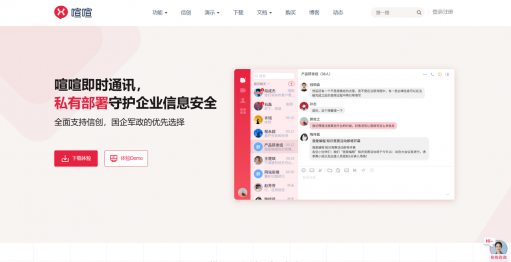
以喧喧IM(禅道软件(青岛)集团有限公司)为例。它把服务端和客户端都放在企业自有的服务器和终端上,客户端覆盖 Windows、macOS、Linux 及移动端;消息类型除文字、图片、文件外还包括代码与 Markdown,讨论组里贴一段代码片段、一份 Markdown 说明,不必先转成截图再发( 即时聊天)。传输与服务端文件采用 AES 256 位加密,消息在数据库中加密存储;组织隔离、消息审计、界面水印、IP 登录限制、LDAP 认证等管控能力,需要结合专业版语境来看。版本分开源版与专业版两档,开源版的核心功能开放,可以自行部署。
如果企业有国产化要求,还要额外核对系统与芯片层面的适配情况, 信创适配范围可以逐项对照。与研发流程的衔接上,这类工具通常通过开放 API、WebHook 和机器人把外部事件转发进会话;喧喧IM 与禅道项目管理集成,任务和缺陷的状态变化能直接回到讨论里,不必在两个系统之间来回搬。
需要提前想清楚的是: 协作工具解决的是"信息到没到",判断和决策仍然要靠流程和人。
起步路径与边界:先固定环境,再补协作层
如果现在只有几台装了 Linux 的机器,按下面的顺序推进,比一次性上全套工具更稳:
- 把环境写成代码。安装脚本、镜像、配置仓库,目标是换一个人也能复现同样的结果。
- 让构建和测试跑在同一环境。先跑通,再谈速度和并行。
- 补齐观测与权限。日志留存、账号与访问控制、必要的审计。
- 最后处理协作层。数据能不能出企业,决定了走私有化还是公有云。
- 小范围试起来。服务端部署包与 Linux、Windows、macOS 客户端可以直接 下载,实际验证比看功能清单可靠。
几条边界值得反复提醒: 研发环境不要顺手承担生产职责,单机不等于高可用;权限和网络边界最好在部署初期定好,事后收紧代价很高;工具能缩短信息传递的路径,但不会自动理顺流程。研发团队的具体协同场景和部署方式,可以参考 面向软件开发与游戏团队的方案。
回到最初的问题:Linux 研发环境除了敲代码还能做什么?它能编译、能测试、能跑服务、能排障、能管住权限和边界,也能承载团队的日常沟通。这些能力之所以能落在同一个地方,是因为它们共享同一条内核和同一套可脚本化的工具链。 能敲代码只是这套环境的起点,不是它的全部。
 639

 获取方案
 联系我们
 社群交流