企业 IM 并发与容量怎么测:一份可复用的压测方案
企业 IM 压测不能只看并发数。本文给出一套可复用方案:先统一在线、活跃、并发与长连接的口径,再用真实业务和群聊扇出算出负载,设计建连、心跳、单聊、群聊、广播、文件和重连场景,最后把压测拐点换算成安全容量,并输出能支持扩容决策的报告。
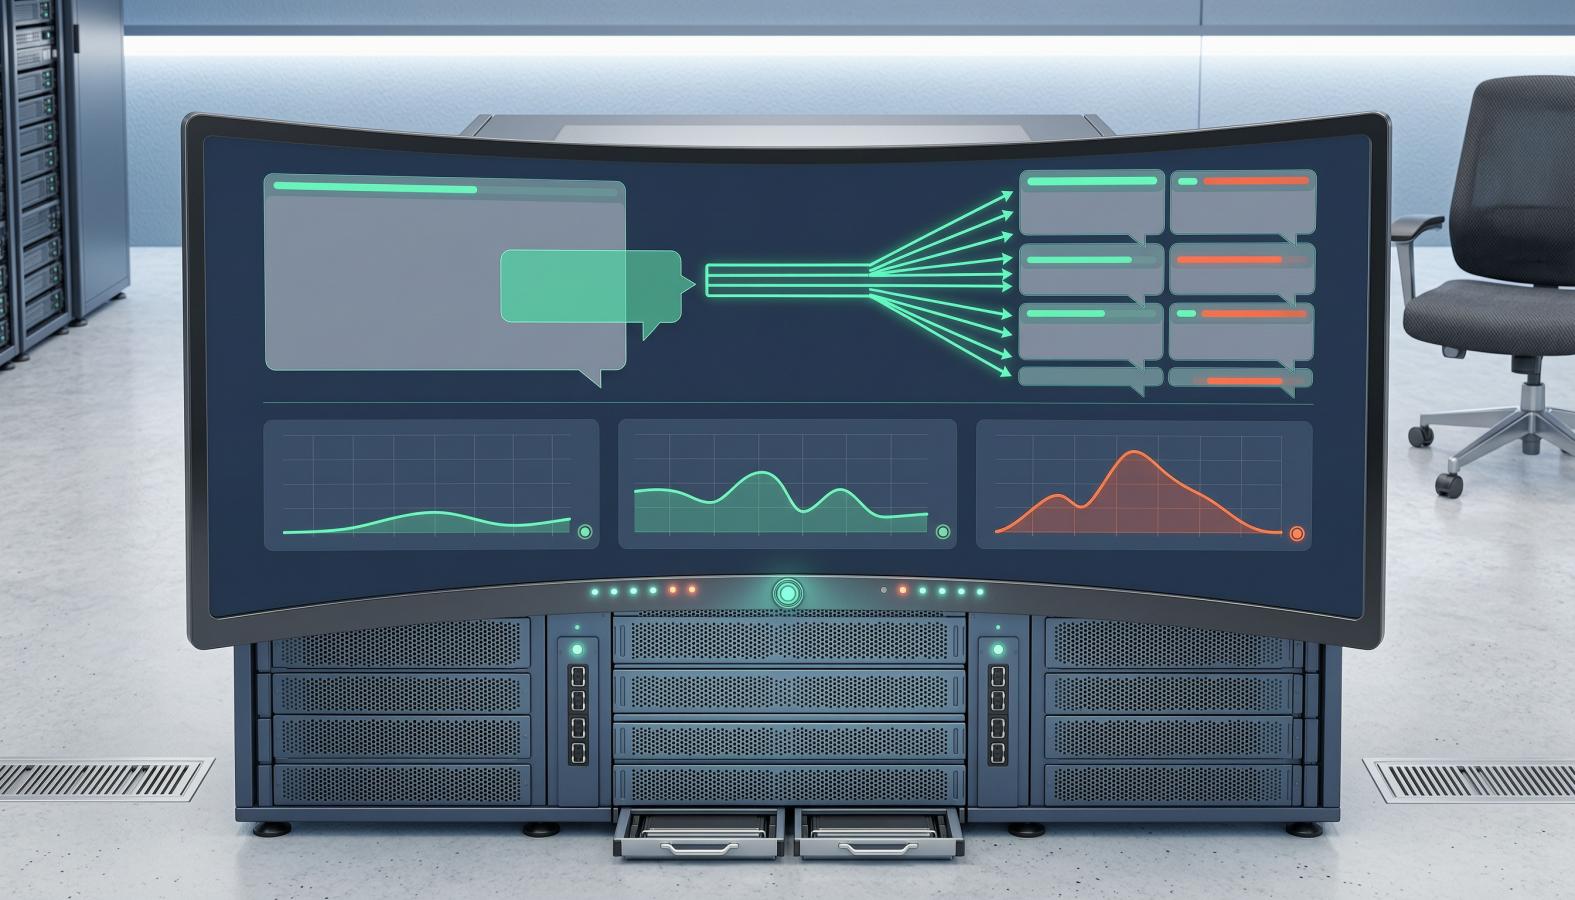
企业 IM 压测和普通 Web 接口不一样。用户登录后建立的是长连接,连接会一直挂着;一条消息要经过发送、回执、推送、存储多段链路;群聊还会把一条消息扩散给多个成员。只压登录接口,或者只盯着一个并发数,得到的结论很容易失真。
这篇给一套可以复用的做法:先把业务目标翻译成指标,再用真实业务算出负载,设计覆盖连接、消息和异常恢复的场景,最后把压测结果换算成可执行的容量结论。方法不依赖某一个产品,文中的喧喧IM 示例用于说明 私有化部署场景下的观察点。
压测前先定口径:企业 IM 要测哪几类指标
IM 并发测试的第一步不是选工具,而是统一口径。
在线、活跃、并发不是一回事
在线用户是保持登录状态的人,可能长时间不发消息;活跃用户是在统计周期内有操作的人;并发用户是同一时刻正在发起请求的人。三者数量依次递减,压测报告里混用,数字就没法比较。
IM 还有一层特殊口径:长连接数。一个用户可能同时登录桌面端和手机端,连接数会大于用户数。压测计划里要写清楚测的是在线用户、活跃用户、并发请求,还是长连接。
长连接、消息吞吐、延迟、可靠性四组指标
- 连接类:建连成功率、当前连接数、连接建立耗时、心跳超时率、异常断开率。
- 吞吐类:消息发送 TPS、消息接收 TPS、消息投递成功率。发送 TPS 是客户端往服务端发的速度;接收 TPS 是服务端往客户端推的速度,群聊场景下后者通常更高。
- 延迟类:端到端延迟,从发送端发出到接收端收到的时间。看 P50、P95、P99,不要只看平均值。平均值会把少数极慢请求盖掉。
- 可靠性类:消息丢失率、重复率、乱序率、断线重连成功率。IM 里丢一条消息,比慢几百毫秒更严重。
资源侧同时看 CPU、内存、网络带宽、磁盘 I/O、数据库连接数和慢查询。业务指标和资源指标要放在同一时间轴上,否则很难判断是流量涨了,还是某个资源先饱和。
把业务体验写成验收线
验收线要按业务定,不能直接抄一个通用值。下面是一组示例,用来说明口径怎么落,不是行业标准。
| 指标 | 示例验收线 | 说明 |
|---|---|---|
| 建连成功率 | ≥ 99.9% | 不含客户端主动取消 |
| 消息投递成功率 | ≥ 99.99% | 按发送到接收端确认统计 |
| 端到端延迟 P95 | ≤ 500 ms | 按业务可接受范围调整 |
| 端到端延迟 P99 | ≤ 1 s | 关注长尾 |
| 错误率 | ≤ 0.1% | 不含客户端主动断开 |
| CPU | 持续 ≤ 70% | 预留突发余量 |
实时性要求高的场景可以把延迟收紧,可靠性要求高的场景优先保证送达率。 验收线要在压测前和业务方确认,压完再改口径,结论就失去意义。
从真实业务算出负载,而不是先定一个并发数
收集峰值在线、消息量和群规模
至少收集这些数据:
- 峰值在线用户数和峰值长连接数
- 日均消息量、峰值时段每分钟消息数
- 单聊、群聊、系统通知的比例
- 群规模分布,多少个小群、多少个大群、最大群多少人
- 文件上传下载的频率和平均大小
- 历史消息保留量,以及客户端首次登录要拉取多少数据
没有现网数据时,用组织人数、部门结构、工作时间活跃比例做估算,并在报告里标明这是假设。不要为了让数字好看,把假设写成实测。
群聊扇出会放大接收侧压力
单聊一条消息通常只有一个接收方。群聊一条消息要投递给群内所有在线成员。一个 500 人的群,如果 200 人在线,一条消息就产生 200 次推送。发送侧只看到 1 条消息,接收侧看到 200 条。
所以负载模型要分别算发送量和接收量:
- 发送消息数/秒 = 单聊发送 + 群聊发送 + 系统通知
- 接收消息数/秒 ≈ 单聊接收 + Σ(每个群的消息数 × 该群在线成员数)+ 广播
群越大,扇出越明显。压测场景里要把大群单独拿出来,不要只用小群的平均值代表全部。
一个可复用的负载模型算例
假设一家 5000 人的企业,工作日峰值 4000 人在线,人均同时 1.2 个连接,长连接数约 4800。峰值时段每分钟产生 12000 条消息,其中单聊 40%、群聊 50%、系统通知 10%。
- 平均发送速率:12000 ÷ 60 = 200 条/秒
- 峰值系数按 2 倍:400 条/秒
- 群聊部分:100 条/秒,平均每个群 100 人、在线率 60%,平均扇出 60,接收侧约 6000 条/秒
- 加上单聊和通知,接收侧峰值可能到 6500 条/秒
发送 400 条/秒的系统,接收侧要扛 6000 条/秒以上。 压测脚本如果只统计发送成功,会严重低估服务端压力。实际建模时把群规模分布做成几档,分别算扇出,再加权汇总。
场景设计要覆盖连接、消息和异常恢复
建连与心跳:先验证长连接能不能稳住
场景目的是验证大量客户端同时登录、建立长连接后,连接能不能稳定保持。
做法是用轻量客户端分批建立连接,达到目标连接数后保持一段时间,按客户端实际心跳间隔发送心跳,统计建连成功率、心跳超时率、异常断开率、内存增长。
浏览器端通常很难模拟上万条 WebSocket 连接,受单域名连接数和内存限制。万级连接一般要用 Node.js、Go 或 Python 的客户端,或者用支持长连接的压测工具分布式发压。
单聊、群聊与广播:分别压发送和接收
单聊关注点对点消息的发送、回执、投递延迟。群聊关注扇出后的接收吞吐和推送延迟。广播或系统通知关注一次写入、大量分发的放大效应。
每个场景都要有发送端和接收端。只发不收,测不到服务端推送和客户端消费的能力;只收不发,测不到消息写入和存储链路。以喧喧IM 为例,单聊、群聊和文件传输的具体能力可以参考 即时聊天页面。
文件、离线消息与断线重连:容易被漏掉的压力
文件上传会占用带宽和磁盘,文件越大、并发越高,网络和存储越容易先饱和。离线消息在用户重新登录时集中拉取,可能形成瞬时读压力。断线重连会带来建连风暴,尤其是网络抖动或服务端重启后。
这些场景不一定每轮都跑,但上线前至少验证一次。它们往往不是吞吐瓶颈,而是恢复能力的短板。
场景矩阵与通过标准
| 场景 | 负载 | 主要观察 | 通过标准示例 |
|---|---|---|---|
| 登录建连 | 目标连接数的 50%、100% | 建连成功率、建连耗时、内存 | 成功率 ≥ 99.9%,P95 建连 ≤ 2 s |
| 心跳保活 | 目标连接数,持续 2 h | 心跳超时率、异常断开率 | 超时率 ≤ 0.1% |
| 单聊 | 目标发送 TPS | 发送/接收 TPS、P95 延迟 | 投递成功率 ≥ 99.99% |
| 群聊 | 按群规模分档 | 接收 TPS、扇出延迟 | P95 接收延迟 ≤ 1 s |
| 广播 | 一次写入、N 个在线接收 | 推送完成时间、带宽 | 5 分钟内完成推送 |
| 文件上传 | 目标并发和文件大小 | 带宽、磁盘 I/O、失败率 | 失败率 ≤ 0.1% |
| 断线重连 | 分批断开后重连 | 重连成功率、恢复时间 | 5 分钟内恢复 95% 连接 |
表格里的数字同样是示例,按自己的业务改。 场景设计的目的不是把每个数字都跑到最大,而是覆盖会真实发生的压力组合。
环境、数据和工具准备
压测环境要接近生产,压测机不能自己先成为瓶颈
压测环境尽量使用和生产相同的版本、配置、网络路径和部署方式。数据库里要有接近真实的数据量,空库压出来的结果通常偏乐观。
压测机要和被测系统分开,单独监控压测机的 CPU、内存、网络和连接数。压测机跑满时,TPS 上不去可能是发压端的问题,不是服务端的问题。连接数很大时,单台压测机通常不够,需要多台分布式发压。
如果只能在生产环境压测,选低峰期,限制压测流量,准备好停止和回滚方案,不要影响真实用户。
用户、群组和历史消息要按真实比例构造
准备数据时至少覆盖:
- 用户数量和部门结构,按真实比例分布
- 群组数量和群规模分布,包含小群、中等群和大群
- 好友关系和群成员关系,关系链会影响消息路由
- 历史消息量,按保留周期估算
- 文件附件,按真实类型和大小准备
数据要参数化,避免所有虚拟用户用同一个账号、同一个群、同一条消息。重复数据会命中缓存,压出来的结果比真实情况好。
监控要同时看业务指标和资源指标
业务侧监控连接数、发送/接收 TPS、延迟分位数、错误率、消息积压。资源侧监控 CPU、内存、网络带宽、磁盘 I/O、数据库连接池、慢查询、缓存命中率。
所有监控统一时间戳,压测开始、加压、停止的时间点要标记在图表上。否则事后很难把延迟上升和某个加压动作对应起来。
喧喧IM 的三层架构怎么分工观察
喧喧IM 的服务端分为业务服务端 XXB 和消息中转服务器 XXD,客户端 XXC 通过 WebSocket 长连接接入 XXD。XXD 负责连接维护、消息实时收发和文件中转,XXB 负责业务逻辑、数据存储和管理接口。
压测时分开看:
- XXD:连接数、CPU、内存、网络带宽、消息转发延迟。连接数上不去或内存持续上涨,先查这一层。
- XXB:接口响应时间、PHP 进程数、数据库连接数、慢查询。
- MySQL:写入 TPS、锁等待、磁盘 I/O。
- 网络:带宽是否跑满,丢包和重传是否异常。
喧喧IM 官方给出的参考配置是 XXB 和 XXD 各 16G 内存、8 核以上 CPU;音视频服务器 8 核以上,带宽建议 8Mbps 以上。具体安装和升级步骤可以查看 安装升级手册。实际压测时按自己的用户规模、消息模型和文件使用情况调整,不要把这组参考值当成容量上限。后台维护和参数配置可以对照 服务端管理手册。
JMeter、k6 与自研客户端各自适合什么
- JMeter + WebSocket Samplers:适合协议级的功能验证和中等规模压测。插件提供建连、Ping/Pong、请求响应、单写、单读、关闭六类采样器,支持 WSS 和二进制帧。
- k6:脚本用 JavaScript 写,适合把压测放进 CI,支持 WebSocket 场景,指标输出和阈值判断比较直接。
- 自研客户端:用 Go、Node.js 或 Python 写,适合万级连接、复杂消息协议和定制统计。连接数很大时,自研客户端通常比通用工具更可控。
工具不是越重越好。连接数测试和消息吞吐测试可以分开做,连接保持用轻量客户端,消息收发用协议级压测工具。混在一个脚本里,压测机自己容易先成为瓶颈。
WebSocket 脚本的三个关键点
读写要配对。 JMeter 的 WebSocket Samplers 中,单写采样器只发不收,单读采样器只收不发,请求响应采样器是一发一收。读写数量不平衡时,响应可能和请求错位。脚本里要按真实消息流设计收发顺序。
心跳要按客户端真实行为发。 WebSocket 协议定义了 Ping/Pong 控制帧,收到 Ping 要回 Pong。实际客户端还可能发应用层心跳,两者不要混为一谈。压测脚本如果只建连不发心跳,连接可能被中间设备或服务端超时清理,测出来的在线连接数虚高。
要处理重连和超时。 真实网络会抖动,客户端会重连。脚本里设置合理的连接超时、读超时和重连策略,统计重连次数和成功率,不要只统计第一次建连。
一个最小可运行脚本结构
下面是一个 Node.js 客户端的结构示例,用来演示连接、心跳、发送和统计的关系,不是完整生产脚本。
const WebSocket = require('ws');
const url = 'wss://im.example.com:11443';
const ws = new WebSocket(url);
let sent = 0;
let received = 0;
const latencies = [];
ws.on('open', () => {
  // 应用层心跳,间隔按客户端实际配置
  setInterval(() => {
    if (ws.readyState === WebSocket.OPEN) {
      ws.send(JSON.stringify({ type: 'ping', ts: Date.now() }));
    }
  }, 25000);
  // 按目标速率发送业务消息
  setInterval(() => {
    const msg = { type: 'message', to: 'user-2', text: 'load-test', ts: Date.now() };
    ws.send(JSON.stringify(msg));
    sent += 1;
  }, 100);
});
ws.on('message', (data) => {
  received += 1;
  try {
    const msg = JSON.parse(data);
    if (msg.ts) latencies.push(Date.now() - msg.ts);
  } catch (e) {
    // 非 JSON 消息不计入延迟统计
  }
});
ws.on('close', () => {
  // 记录断开原因,按需重连
});
实际脚本要接入真实登录鉴权、消息协议和 ACK 逻辑,消息体字段以被测系统的接口文档为准。示例里的地址、端口和字段只是占位,不能直接用于生产。
压测前的冒烟检查
正式加压前,用 1 到 10 个虚拟用户跑一遍:
- 登录鉴权是否通过
- 连接是否建立成功
- 心跳是否收到响应
- 消息是否能发出去并收到 ACK
- 接收端是否能收到消息
- 监控图表是否有数据
冒烟不通过就不要加压。很多压测结果异常,根源是脚本没跑通,不是系统性能有问题。
执行阶段:从基线到拐点,再到长稳
基线、梯度、稳态、尖峰四种跑法
基线测试:低负载下跑一段时间,记录正常水位。后面所有异常都要和基线比。
梯度加压:按阶梯增加并发或发送速率,每一档保持足够长时间,观察 TPS、延迟、错误率和资源使用的变化。TPS 不再上升、延迟明显变陡、错误率抬头,说明接近拐点。
稳态测试:在目标负载下持续跑 2 到 4 小时,或者覆盖一个完整业务高峰。观察内存是否持续增长、连接是否泄漏、延迟是否随时间漂移。
尖峰测试:短时间内把负载拉到峰值以上,模拟上班集中登录、全员通知、活动开始等场景。重点看系统能不能扛住瞬时冲击,以及冲击过后能不能恢复。
破坏性测试可选。它的目的不是把系统压垮,而是验证限流、降级和恢复机制是否有效。生产环境不建议做。
什么时候应该停止加压
提前定好停止条件,例如:
- 错误率超过验收线
- P99 延迟超过验收线的 2 倍
- CPU 持续超过 85%
- 内存使用率持续超过 90% 或出现 Swap
- 数据库连接池耗尽或慢查询大量堆积
- 压测机自身资源接近饱和
触发停止条件后先记录现场,再降压。 不要为了凑一个更大的数字继续压,压垮系统得到的数字没有容量意义。
每轮必须记录的变量
版本号、部署方式、服务器配置、操作系统和数据库版本、压测脚本版本、数据量、连接数、发送速率、持续时间、网络环境、压测机配置。少记一项,复现时就说不清差异来自哪里。
结果分析:先排除假瓶颈,再谈容量
三类常见假瓶颈
压测机瓶颈:压测机 CPU、内存、网络或文件描述符跑满,发不出更多请求。表现是压测机资源高、服务端资源低。
网络瓶颈:带宽跑满、丢包、重传、NAT 超时。表现是延迟整体抬升,服务端 CPU 不高。
下游依赖瓶颈:数据库连接池、缓存、第三方接口、文件存储。表现是应用层 CPU 不高,但请求大量等待。
先排除这三类,再判断服务端真实容量。否则容易把压测机的问题当成系统上限。
找到最先饱和的那一层
沿着链路看:客户端、网络、XXD、XXB、MySQL 和存储。哪一层的指标先到阈值,它就是当前瓶颈。扩容或优化应该针对这一层,而不是所有层一起加资源。
举个常见情况。XXD 的 CPU 和连接数都很健康,但消息延迟降不下来,XXB 的数据库连接池已经打满,慢查询增多。这时加 XXD 的资源没用,应该先处理数据库写入或查询。
容量换算与安全系数
压测得到的拐点不是可以直接上线的容量。常用做法是乘一个安全系数,比如 0.7,再叠加业务增长和峰值冗余。
示例:实测在 6000 个长连接、发送 500 条/秒、接收 5000 条/秒时,P95 延迟和错误率都在验收线内,继续加压到 8000 连接时延迟明显超标。那么单机安全容量可以按 6000 × 0.7 = 4200 个长连接估算,再结合业务峰值和增长预留。
这个数字还要和数据库、带宽、磁盘的上限取最小值。应用层能扛 4200 连接,但带宽只够 3000 连接,实际容量就是 3000。 容量结论取最短板,不取最高分。
厂商标称值怎么用
厂商标称的并发能力可以作为选型参考,不能直接当成自己的容量结论。喧喧IM 官方资料标称支持 10000+ 用户同时在线,实际能承载多少,取决于服务器配置、消息模型、群规模、文件使用和网络条件。用本文的方法在自己的环境里测一遍,得到的数字才是可执行的。
把一轮压测沉淀成可复用的报告
报告要能支持扩容决策
一份能用的报告至少包含:
- 压测目标和验收线
- 环境、版本、配置和数据量
- 负载模型和计算过程
- 场景、脚本和每轮参数
- 结果数据,包括连接数、TPS、延迟分位数、错误率和资源曲线
- 瓶颈分析和证据
- 容量结论,包括安全容量、最短板和扩容建议
- 风险和未验证项
- 复测计划
结论要落到动作上:是加 XXD 的内存,还是加数据库连接池,还是限制大群扇出,还是调整心跳间隔。只写“系统性能良好”没有决策价值。
复测触发条件和资产沉淀
版本升级、架构调整、数据量翻倍、业务峰值变化、网络环境变化,都应该触发复测。把脚本、数据生成器、监控面板和基线数据沉淀下来,下一次压测就不用从零开始。
压测方案的价值不在于跑出一个最大数字,而在于形成一套可重复的验证方法。每次版本变更都能快速回答一个问题:现在的系统,还能不能撑住已知的业务峰值。
FAQ
没有生产数据,负载模型怎么起步
先用组织人数、部门结构、工作时间活跃比例和群规模分布做估算,把假设写清楚。上线后拿真实监控数据修正模型。没有数据时不要拍一个并发数就开压,至少把发送量、接收量和群扇出分开估算。
并发用户数到底该取多少
先确定业务峰值在线人数,再根据活跃比例估算同时操作人数,最后换算成消息发送速率。IM 的长连接数通常大于在线用户数,因为一个用户可能多端登录。压测计划里要明确测的是连接数还是消息并发,两者不能混用。
WebSocket 压测和 HTTP 压测最大的区别是什么
HTTP 通常是一问一答,连接用完就释放;WebSocket 是持久连接,建连之后要一直保持,还要处理心跳、推送、重连和消息顺序。只压 HTTP 登录接口,测不到长连接保持、消息推送和扇出带来的压力。
压测把系统压挂了怎么办
先停止加压,保留日志和监控现场,按预案恢复。压挂本身不是失败,前提是知道为什么挂、挂在哪一层、恢复需要多久。生产环境压测要提前准备限流、降级和回滚方案,不要在业务高峰做破坏性测试。
企业 IM 的容量只看在线人数够不够
不够。在线人数只反映连接规模,不反映消息量、群扇出、文件传输和数据库压力。两个同样 5000 人在线的企业,一个以单聊为主,一个有大群和大量文件传输,容量需求可能差很多。容量结论至少要同时给出连接数、发送 TPS、接收 TPS 和延迟。
 67
 获取方案
 联系我们
 社群交流